Вспомните: искажённые буквы, два слова в рамке, один из них непонятен — и вы угадываете, что там написано. Эта маленькая, часто раздражавшая рутина с 2008 года работала не только на безопасность. Уже в первой научной публикации разработчиков из Carnegie Mellon предлагалось использовать ответы людей как инструмент для транскрипции фрагментов текста, не распознанных машиной.
От идеи в журнале Science до сотен миллионов слов
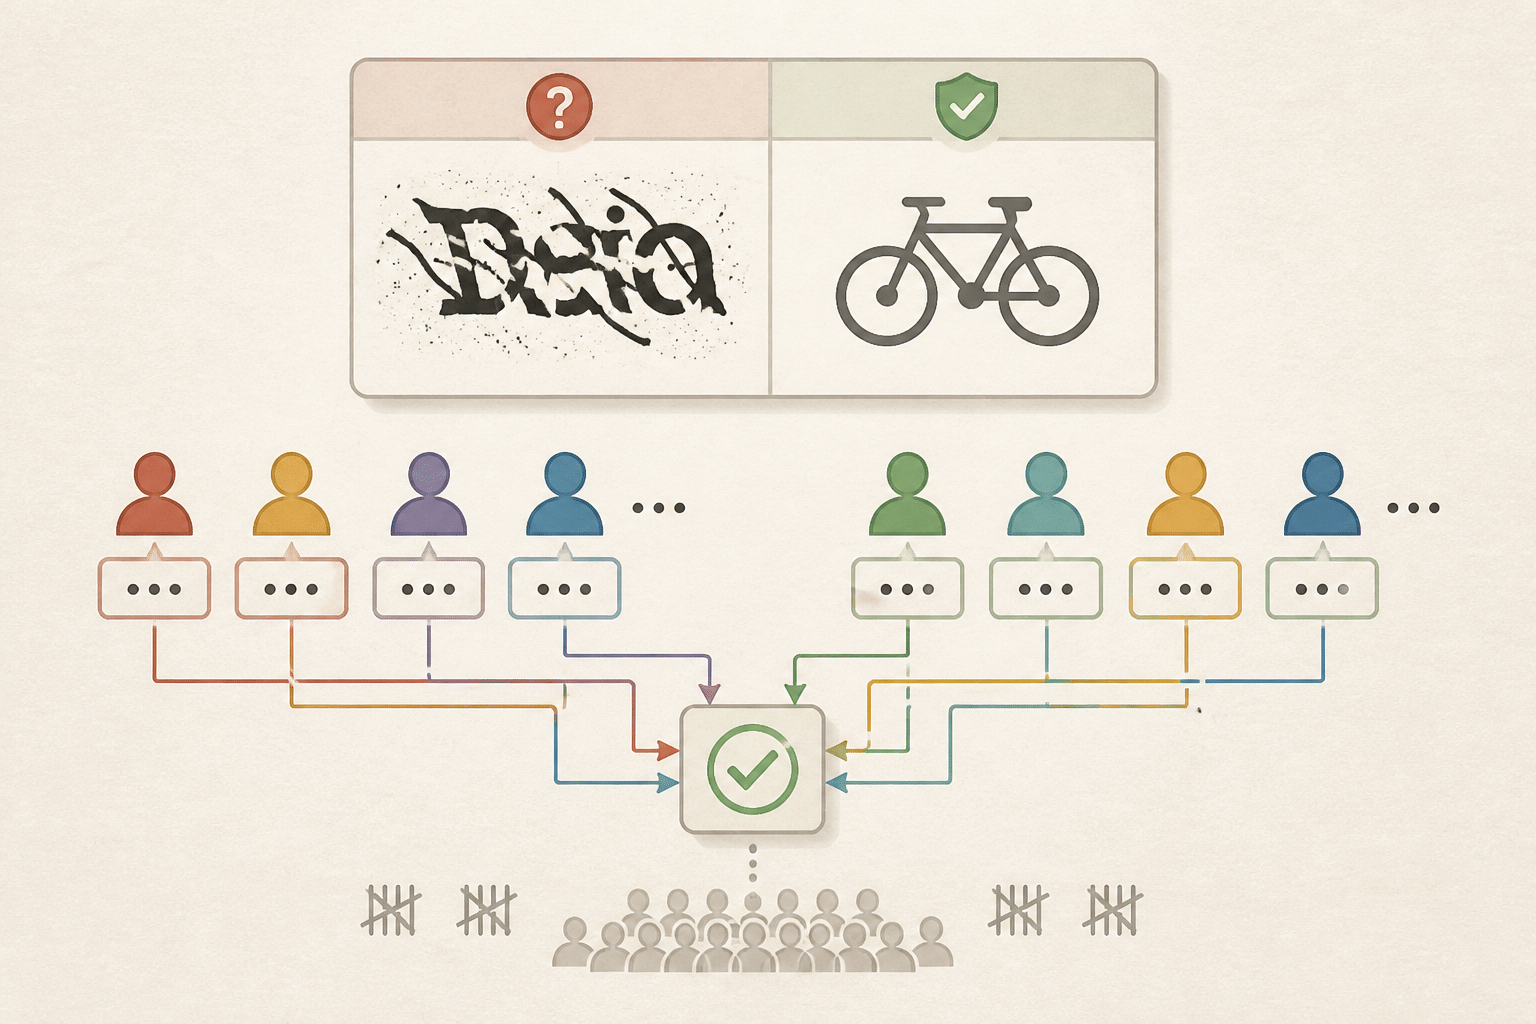
12 сентября 2008 года в Science вышла статья «reCAPTCHA: Human‑Based Character Recognition via Web Security Measures» (Luis von Ahn и соавторы). Авторы описали простую, но мощную идею: показывать пользователю два слова — одно контрольное, другое — из нераспознанного OCR‑фрагмента — и агрегировать ответы разных людей для надёжной транскрипции. По данным той же публикации, система была развернута более чем на ~40 000 сайтах и успела расшифровать свыше 440 миллионов слов; авторы оценивали точность итоговой транскрипции примерно на уровне 99% при объединении мнений пользователей. Кроме того, в статье отмечался порядок величины — люди вводят более 100 миллионов CAPTCHA в день.
Когда Google сказал «учим компьютеры читать»
16 сентября 2009 года Google объявил о приобретении reCAPTCHA и прямо заявил, что технология будет применяться для помощи в оцифровке книг и газет. В последующие годы механизм вышел за пределы только печатного текста: в результате репортажей и материалов судебных документов стало известно, что Google показывал пользователям фрагменты с номерами домов и уличными табличками (данные Street View), чтобы уточнять подписи и адреса. Эти шаги показали, что идея превратить человеческую проверку в размеченные данные может работать и для изображений, а не только для искажённых букв.
От видимых букв к «невидимому» скорингу
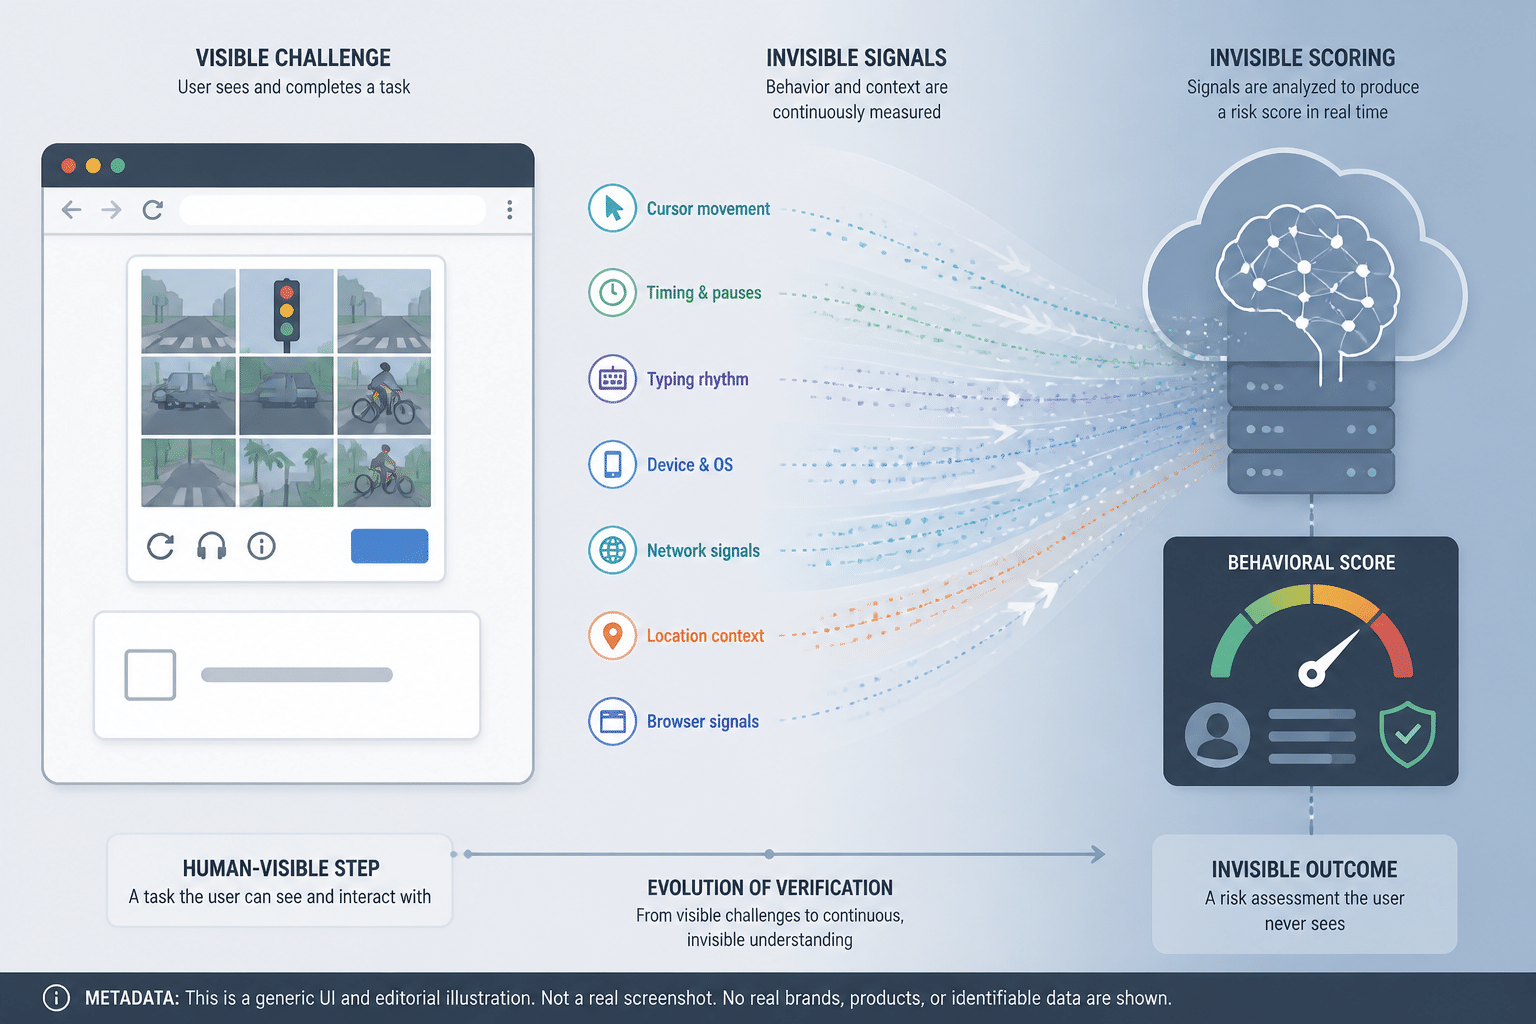
По мере развития алгоритмов текстовые искажённые CAPTCHA теряли смысл как надёжный рубеж: 3 декабря 2014 года Google представил «No CAPTCHA reCAPTCHA» — знакомый многим флажок «I’m not a robot» с резервными визуальными заданиями. Затем, 29 октября 2018 года, появилась reCAPTCHA v3, которая возвращает «оценку риска» на основе фоновых сигналов и поведения, часто без явных испытаний для пользователя. Таким образом система прошла путь от явных текстовых транскрипций к комбинации image‑челленджей и невидимых поведенческих сигналов.
Исследователи по краудсорсингу и обозреватели отмечают: такие механики фактически превращают пользователей в источник помеченных данных для задач компьютерного зрения — от OCR до распознавания объектов на фото. Журналистские обзоры это тоже подмечали как пример масштабного, невознаграждённого сбора меток, который одновременно служит защите сайтов от ботов и улучшению машинного интеллекта.
Что важно знать о масштабе и границах
Ключевые вехи — статья в Science (12.09.2008), покупка Google (16.09.2009), «No CAPTCHA» (03.12.2014) и v3 (29.10.2018) — подтверждены официальными и первичными источниками. При этом публичных подробных метрик по объёмам image‑разметки после 2008 года Google не публиковал; также нельзя утверждать, что каждая введённая пользователем метка немедленно попала в конкретный коммерческий продукт без явных подтверждений.
И всё же главный ответ прост: да, многие из тех скучных кликов действительно были полезны — они стали частью инфраструктуры, которая помогала системам «учиться читать» и распознавать объекты. Сегодня reCAPTCHA стала менее навязчивой, но по сути превратилась в механизм сбора сигналов и пометок, встроенный в повседневный веб‑опыт.
Так что в следующий раз, когда придётся поставить галочку или выбирать картинки с пешеходным переходом — можно улыбнуться: вы не просто доказываете, что не робот, вы одна из миллионов человеческих подсказок, которые помогали машинам понимать мир букв и картинок чуть лучше.